

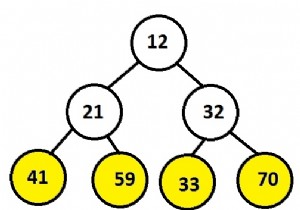


대입법(Substitution Method)이란?이 글에서는 대입법을 사용하여 점화식(recurrence relation)을 푸는 방법을 살펴봅니다. 이진 탐색과 병합 정렬이라는 두 가지 대표적인 예제를 통해 개념을 더욱 명확하게 이해할 수 있습니다.대입법은 점화식의 우변에 있는 재귀 항목에 동일한 식을 반복적으로 대입하면서 일반적인 패턴을 찾아내고, 이를 통해 알고리즘의 전체 시간 복잡도를 유도하는 방법입니다.예제 1: 이진 탐색(Binary Search)이진 탐색은 정렬된 배열에서 특정 원소를 찾는 기법입니다. 먼저 배열의 중앙
데이터베이스 운영에서 미러링(Mirroring)과 복제(Replication)는 모두 가용성과 데이터 안정성을 높이기 위해 사용되는 기술입니다. 두 기술은 비슷해 보이지만 목적과 동작 방식, 적용 범위에서 뚜렷한 차이가 있습니다. 이 글에서는 두 개념을 각각 살펴보고, 주요 차이점을 표로 정리해 명확하게 비교해 드립니다.미러링(Mirroring)이란?미러링은 마스터(Master) 데이터베이스 서버에 대한 백업용 데이터베이스 서버를 별도로 유지하는 방식을 의미합니다. 마스터 데이터베이스에 장애가 발생해 다운되면, 미러 데이터베이스가
선형 데이터 구조(Linear Data Structure)란?선형 데이터 구조는 데이터 요소들이 순차적으로 배치되어 있으며, 각 요소가 바로 앞의 요소와 바로 뒤의 요소에 연결된 형태입니다. 이러한 연결 구조 덕분에 한 번의 순회(single run)만으로 모든 요소를 한 단계씩 탐색할 수 있습니다. 또한 컴퓨터 메모리 역시 순차적으로 구성되어 있기 때문에 선형 데이터 구조는 구현이 비교적 쉽다는 장점이 있습니다. 대표적인 예로는 배열(Array), 리스트(List), 큐(Queue), 스택(Stack) 등이 있습니다.비선형 데이터
빅데이터(Big Data)는 방대한 양의 데이터와 이를 처리하는 과정 전반을 다루는 개념입니다. 데이터의 규모가 워낙 거대하다 보니, 데이터가 얼마나 체계적으로 구조화되어 있는지에 따라 크게 세 가지 유형으로 분류할 수 있습니다. 바로 정형 데이터(Structured Data), 반정형 데이터(Semi-Structured Data), 비정형 데이터(Unstructured Data)입니다.세 유형은 데이터의 구조화 수준을 기준으로 구분되며, 이 기준에 따라 저장 방식, 트랜잭션 관리, 버전 관리, 유연성, 성능 등 여러 측면에서 뚜렷
불의 부등식(Booles Inequality)이란?확률론에서 불의 부등식(Booles Inequality)은 합집합 상한(Union Bound)이라고도 불리는 중요한 정리입니다. 이 부등식에 따르면, 유한하거나 셀 수 있는(countable) 사건들의 집합이 있을 때, 그중 적어도 하나의 사건이 발생할 확률은 각 사건의 확률을 단순히 모두 더한 값보다 크지 않습니다.확률론의 기본 개념수학에서 확률론(probability theory)은 무작위 사건(random event)의 발생 가능성을 연구하는 핵심 분야입니다. 여기서 확률이란
베이즈 법칙이란 무엇인가?베이즈 법칙(Bayes Rule)은 새롭고 관련성 있는 증거가 도착했을 때, 우리가 가지고 있던 기존의 믿음(확률)을 체계적으로 갱신할 수 있는 방법을 제공하는 통계학의 핵심 원리입니다.예를 들어, 어떤 사람이 암에 걸렸을 확률을 계산한다고 가정해 봅시다. 아무런 추가 정보가 없다면, 초기 확률은 단순히 인구 전체에서 암 환자가 차지하는 비율이 됩니다. 그러나 그 사람이 흡연자라는 사실과 같은 추가 증거가 주어지면 상황이 달라집니다. 흡연자일 경우 암에 걸릴 확률이 일반 인구보다 높기 때문에, 우리는 초기
사전(Dictionary)은 여러 객체를 저장하기 위한 범용 데이터 구조로 정의됩니다. 사전은 키(Key) 집합과 연결되어 있으며, 각 키에는 하나의 값(Value)이 대응됩니다. 특정 키가 주어지면 사전은 해당 키와 연관된 값을 즉시 반환합니다.사전의 기본 개념예를 들어, 교실 시험 결과를 사전으로 표현할 수 있습니다. 이때 학생 이름이 키가 되고, 점수가 값이 됩니다.results = {Anik : 75, Aftab :80, James : 85, Manisha: 77, Suhana :87, Margaret: 82}위 예제에서 A
허프만 트리란 무엇인가?허프만 코딩(Huffman Coding)은 문자마다 코드를 부여하는 기법으로, 코드의 길이가 해당 문자의 상대적 빈도나 가중치에 따라 결정됩니다. 즉, 자주 사용되는 문자에는 짧은 코드를, 드물게 사용되는 문자에는 긴 코드를 할당하여 전체 데이터를 효율적으로 압축할 수 있습니다.허프만 코드는 가변 길이(variable-length) 방식이며, 접두어가 없는(prefix-free) 특징을 가집니다. 여기서 접두어 없음이란 어떤 코드도 다른 코드의 접두어가 되지 않는다는 의미입니다. 덕분에 디코딩 시 코드 사이의
데이터 웨어하우스란?데이터 웨어하우스(Data Warehouse)는 특정 목적을 위해 미리 가공·처리된 정형화된 데이터를 저장하는 저장소입니다. 여러 데이터 소스에서 데이터를 수집한 뒤 ETL(추출-변환-적재) 과정을 통해 변환하고, 이를 비즈니스 분석 및 의사결정 목적으로 활용하기 위해 데이터 웨어하우스에 적재합니다.운영 데이터베이스란?운영 데이터베이스(Operational Database)는 데이터가 수시로 변경되는 데이터베이스를 의미합니다. 대량의 트랜잭션 처리에 최적화되어 설계되었으며, 데이터 웨어하우스의 원천(Source)
문제 개요이번 글에서는 다음 두 가지 연산을 지원하는 데이터 구조를 설계해 보겠습니다.addWord(word) – 새로운 단어를 저장합니다.search(word) – 저장된 단어를 검색합니다.여기서 search(word) 메서드는 일반 문자열뿐만 아니라 알파벳 소문자(a~z)와 마침표(.)로만 구성된 정규식 형태의 문자열도 처리할 수 있어야 합니다. 마침표(.)는 임의의 한 글자를 대체할 수 있는 와일드카드 역할을 합니다.예를 들어 bad, dad, mad 세 단어를 미리 추가해 둔 상태에서 검색을 수행하면 결
정보 보안 분야에서 스테가노그래피(Steganography)와 암호화(Cryptography)는 모두 중요한 정보를 보호하는 기술이지만, 그 접근 방식과 활용 목적에는 뚜렷한 차이가 있습니다. 이 글에서는 두 기술의 개념을 살펴보고, 주요 차이점을 비교표로 정리해 드립니다. 스테가노그래피(Steganography)란? 스테가노그래피는 은폐된 글쓰기(Cover Writing)를 의미하는 기술로, 비밀 메시지를 겉보기에 평범해 보이는 다른 콘텐츠 안에 숨기는 방법입니다. 예를 들어 이미지, 오디오, 동영상, 텍스트 파일 등에 기밀 정보
가중치 그래프에서 최소 신장 트리(Minimum Spanning Tree, MST)를 구하는 대표적인 방법 중 하나가 바로 크루스칼(Kruskal) 알고리즘입니다. 이 글에서는 크루스칼 알고리즘의 동작 원리, 시간 복잡도, 의사코드, 그리고 실제 C++ 구현 예제까지 단계별로 살펴보겠습니다.크루스칼 알고리즘이란?연결 그래프 G(V, E)가 있고, 모든 간선마다 가중치(비용)가 주어져 있다고 가정해 봅시다. 크루스칼 알고리즘은 이 그래프와 비용 정보를 이용해 전체 가중치의 합이 최소가 되는 신장 트리를 찾아냅니다.이 알고리즘은 트리
프림(Prim) 알고리즘이란? 모든 정점이 연결된 그래프 G(V, E)가 주어지고, 각 간선에는 가중치(비용)가 부여되어 있다고 가정합니다. 프림(Prim) 알고리즘은 이 그래프에서 최소 신장 트리(Minimum Spanning Tree, MST), 즉 모든 정점을 연결하면서 간선 가중치의 합이 최소가 되는 트리를 찾아내는 대표적인 탐욕(Greedy) 기반 알고리즘입니다. 프림 알고리즘은 성장 트리(growing tree) 방식으로 동작합니다. 하나의 시작 정점(시드, seed)에서 트리를 시작한 뒤, 가중치가 가장 작은 간선을
음이 아닌 가중치를 가진 그래프에서 단일 출발점(single source) 최단 경로를 구하는 알고리즘은 널리 다익스트라(Dijkstra) 알고리즘으로 알려져 있습니다. 이 문제에서는 인접 행렬(adjacency matrix)로 표현된 그래프 G(V, E)와 하나의 시작 정점(source vertex)이 주어지며, 다익스트라 알고리즘을 이용해 시작 정점에서 그래프의 다른 모든 정점까지의 최소 비용 경로를 찾습니다.시작 노드에서 임의의 다른 노드까지 이동할 때 가장 작은 거리를 구하는 것이 목표입니다. 이 문제에서 그래프는 인접 행렬
단일 출발점 최단 경로(Single Source Shortest Path) 알고리즘은 양수든 음수든 임의의 가중치를 가진 그래프에서 시작 정점으로부터 다른 모든 정점까지의 최소 거리를 구하는 알고리즘이며, 일반적으로 벨만-포드(Bellman-Ford) 알고리즘이라고 불립니다. 다익스트라(Dijkstra) 알고리즘과의 가장 큰 차이점은, 다익스트라 알고리즘에서는 음수 가중치를 처리할 수 없지만 벨만-포드 알고리즘에서는 이를 손쉽게 처리할 수 있다는 점입니다. 동작 원리 벨만-포드 알고리즘은 상향식(bottom-up) 방식으로 거리
플로이드-워셜 알고리즘이란?모든 쌍 최단 경로(All-Pair Shortest Path) 알고리즘은 흔히 플로이드-워셜(Floyd-Warshall) 알고리즘이라는 이름으로도 널리 알려져 있으며, 가중치 그래프에서 임의의 두 정점 사이의 최단 경로를 한 번에 구하는 대표적인 동적 계획법 기반 알고리즘입니다. 이 알고리즘을 수행하면 그래프 내 어떤 노드에서 다른 모든 노드까지의 최소 거리를 담고 있는 행렬(matrix)이 결과물로 생성됩니다.동작 방식은 다음과 같습니다. 처음에 출력 행렬은 그래프의 비용 행렬(cost matrix)과
허프만 코딩이란?허프만 코딩(Huffman Coding)은 대표적인 무손실 데이터 압축(lossless data compression) 알고리즘입니다. 이 알고리즘은 입력 문자열의 각 문자에 가변 길이 코드(variable-length code)를 부여하는 방식으로 동작하며, 코드의 길이는 해당 문자가 사용되는 빈도에 따라 결정됩니다.핵심 원리는 간단합니다. 자주 등장하는 문자에는 짧은 코드를, 드물게 등장하는 문자에는 긴 코드를 할당함으로써 전체 데이터의 크기를 효율적으로 줄일 수 있습니다.허프만 코딩은 크게 두 단계로 구성됩니다
재귀(recursion)란 함수가 자기 자신을 다시 호출하는 프로세스를 의미합니다. 재귀는 하나의 큰 문제를 더 작은 하위 문제들로 나누어 해결할 때 활용됩니다. 다만 한 가지 유의해야 할 점이 있습니다. 각 하위 문제가 모두 동일한 패턴을 따를 때에만 재귀적 접근 방식을 적용할 수 있다는 것입니다.재귀 함수는 두 가지 서로 다른 부분으로 구성됩니다. 바로 기저 사례(base case)와 재귀 사례(recursive case)입니다. 기저 사례는 재귀 호출을 멈추고 작업을 종료하는 역할을 담당합니다. 만약 기저 사례가 정의되어 있지
스택(Stack)은 후입선출(LIFO, Last In First Out) 방식으로 동작하는 대표적인 데이터 구조입니다. 가장 나중에 삽입된 데이터가 가장 먼저 삭제되는 이 특성 덕분에, 스택은 컴퓨터 공학 전반에서 다양한 중요한 용도로 활용됩니다. 아래에서 그 대표적인 응용 분야를 살펴보겠습니다.1. 수식(Expression) 처리중위 표기법 → 후위·전위 표기법 변환스택은 중위 표기법(Infix)으로 작성된 수식을 후위 표기법(Postfix) 또는 전위 표기법(Prefix) 형태로 변환하는 데 활용됩니다. 컴퓨터는 사람이 익숙하게
데이터베이스의 구조를 변경하는 과정은 크게 두 가지 방식으로 나눌 수 있습니다. 하나는 정규화(Normalization)이고, 다른 하나는 비정규화(Denormalization)입니다.정규화는 중복 데이터를 제거하고 일관성 있는 데이터를 저장하기 위해 테이블을 분해하는 기법이며, 비정규화는 여러 테이블의 데이터를 하나로 통합하여 조회 성능을 높이는 기법입니다. 두 방식은 서로 반대되는 목표를 가지고 있으며, 시스템의 특성과 요구사항에 따라 적절히 선택해야 합니다.정규화란 무엇인가?정규화는 데이터베이스에서 중복 데이터를 제거하고, 데