일반화 리스트란 무엇인가?
일반화 리스트(Generalized List)는 기존의 선형 리스트를 확장한 자료 구조로, 리스트 안에 또 다른 리스트를 포함할 수 있다는 점이 특징입니다. 공식적인 정의는 다음과 같습니다.
일반화 리스트 L은 n개(n ≥ 0)의 원소로 이루어진 유한한 순서열입니다. 각 원소 ei는 원자(atom), 즉 더 이상 분해되지 않는 단일 요소이거나, 또 다른 일반화 리스트일 수 있습니다. 원자가 아닌 원소 ei들은 모두 L의 부분 리스트(sub-list)가 됩니다.
구체적인 예시
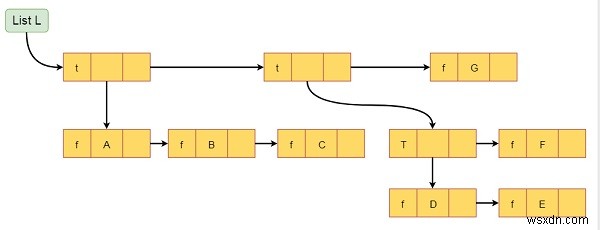
예를 들어 L = ((A, B, C), ((D, E), F), G)라고 가정해 보겠습니다. 이 리스트 L은 세 개의 원소를 가집니다.
- 부분 리스트 (A, B, C)
- 부분 리스트 ((D, E), F)
- 원자 G
여기서 주목할 점은 부분 리스트 ((D, E), F) 역시 두 개의 원소, 즉 부분 리스트 (D, E)와 원자 F로 다시 구성된다는 것입니다. 이처럼 일반화 리스트는 계층적이고 재귀적인 구조를 표현하는 데 매우 유용합니다.
C++로 구현하는 일반화 리스트
C++에서는 노드 클래스를 활용하여 일반화 리스트를 효율적으로 표현할 수 있습니다. 핵심 아이디어는 tag(태그) 필드를 사용해 현재 노드가 원자인지 부분 리스트인지를 구분하는 것입니다.
class GeneralizedListNode{
    private:
        GeneralizedListNode *next;
        bool tag;
        union{
            char data;
            GeneralizedListNode *down;
        };
};
각 멤버의 역할
- tag: true이면 해당 노드가 나타내는 원소는 부분 리스트이고, false이면 원자임을 의미합니다.
- down: tag가 true일 때 사용되며, 부분 리스트의 첫 번째 노드를 가리킵니다.
- next: 같은 레벨에서 다음 원소(노드)를 가리키는 포인터입니다.
union을 사용하면 data(char 값)와 down(포인터)이 메모리를 공유하므로, tag 값에 따라 필요한 멤버만 선택적으로 해석하게 됩니다. 결과적으로 이러한 노드들이 연결되어 전체 일반화 리스트 구조를 형성하게 됩니다.