
직접 메시지 큐(Message Queue)를 만들어 보려다가 어려움을 겪어본 적이 있으신가요? 그렇다면 혼자만은 아닙니다. 이 튜토리얼에서는 Redis 리스트를 활용해 메시지 큐를 처음부터 끝까지 직접 구축해 보겠습니다.
Redis로 메시지 큐를 만드는 방법은 스트림(Streams), 리스트(Lists), Pub/Sub 등 여러 가지가 있지만, 이 글에서는 가장 단순하고 직관적인 방식인 리스트에 집중합니다. 실전 예제를 함께 살펴보시죠.
사용할 도구
- Upstash Redis
필요한 준비물
- Bun 런타임
- TypeScript 기본 지식
Upstash Redis 설정하기
먼저 Redis 인스턴스를 생성해야 합니다. Upstash 콘솔에 접속한 후 Create Database 버튼을 클릭하세요.
데이터베이스가 생성되면 페이지 하단으로 스크롤하여 연결 문자열(Connection String)을 찾을 수 있습니다. 이 문자열이 클라이언트 연결에 사용됩니다.
연결 문자열 예시
redis://XXXXe@social-XXX-39281.upstash.io:39281설정 과정의 세부 사항은 생략하겠습니다. 위 연결 문자열만 있으면 바로 시작할 수 있습니다.
프로젝트 시작하기
Bun으로 TypeScript 프로젝트를 초기화합니다. Bun을 선택한 이유는 Node보다 빠르기 때문만이 아니라, 설정 과정이 훨씬 간편하기 때문입니다. 물론 실행 속도도 놀랍도록 빠릅니다! 🚀
mkdir upstash-mq
cd upstash-mq

bun init
> package name (upstash-mq-tutorial): upstash-mq
> entry point (index.ts):
> Done!

bun add ioredis
프로젝트 구조
 ┣ 📂src
 ┃ ┣ 📂lua-scripts
 ┃ ┃ ┣ 📜add-job.lua
 ┃ ┃ ┗ 📜remove-job.lua
 ┃ ┣ 📜index.ts
 ┃ ┣ 📜job.ts
 ┃ ┣ 📜queue.ts
 ┃ ┗ 📜utils.ts
 ┣ 📜.env
 ┣ 📜.gitignore
 ┣ 📜README.md
 ┣ 📜bun.lockb
 ┣ 📜index.ts
 ┣ 📜package.json
 ┗ 📜tsconfig.json
완성된 Queue의 전체적인 구조는 다음과 같습니다.
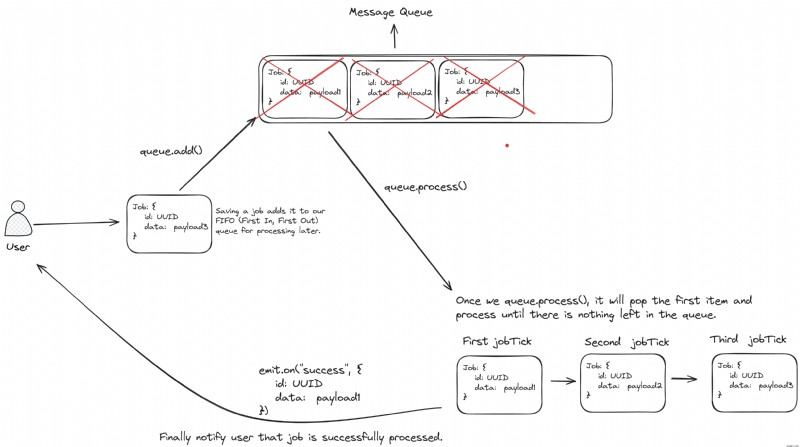
Job 클래스 설계
Job 클래스에는 몇 가지 핵심 요소가 필요합니다.
첫째, 각 작업(Job)의 상태를 추적해야 합니다. 상태 정보가 있어야 해당 작업을 처리할지, 재시도할지, 이미 완료된 작업이라면 다른 곳으로 옮길지 판단할 수 있습니다.
둘째, 각 작업은 고유한 ID와 데이터를 가집니다. 데이터는 어떤 타입이든 담을 수 있도록 제네릭(Generic)으로 설계해야 사용자 경험이 좋아집니다.
셋째, 각 작업이 속한 큐와 큐 이름을 연결해야 관리가 편리합니다.
다음은 Job 클래스의 기본 골격입니다.
type OwnerQueue = {
 redis: Redis;
 queueName: string;
};
export type JobStatuses =
 | "created"
 | "waiting"
 | "active"
 | "succeeded"
 | "failed";

export class Job<T> {
 id: string;
 status: JobStatuses;
 config: OwnerQueue;
 data: T;

 constructor(ownerConfig: OwnerQueue, data: T, jobId = randomUUID()) {
 this.id = jobId;
 this.status = "created";
 this.data = data;
 this.config = ownerConfig;
 }
}data를 제네릭으로 만들려면 먼저 Job 자체가 제네릭이어야 합니다. 나머지는 순차적으로 따라옵니다.
각 Job 인스턴스마다 별도의 Redis 인스턴스를 생성하는 방법도 있지만, 관리가 매우 복잡해집니다.
다행히 우리 방식에서는 Redis 인스턴스를 큐(Queue) 차원에서 설정하고, 필요할 때마다 이 인스턴스를 전달하면 됩니다. queueName도 마찬가지입니다. 작업을 큐에 저장할 때 큐 이름을 자주 사용하므로, 각 작업이 자신의 부모 큐를 알고 있어야 합니다.
작업을 큐에 저장하려면 두 가지가 필요합니다. Redis와 통신할 Lua 스크립트, 그리고 유틸리티 함수입니다.
먼저 유틸리티 함수부터 만들어 보겠습니다.
import { JobStatuses } from "./job";

const MQ_PREFIX = "UpstashMQ";

export const formatMessageQueueKey = (queueName: string, key: string) => {
 return `${MQ_PREFIX}:${queueName}:${key}`;
};

export const convertToJSONString = <T>(
 data: T,
 status: JobStatuses,
): string => {
 return JSON.stringify({
 data,
 status,
 });
};
Redis를 사용할 때마다 큐 키 이름을 일일이 조합하는 것은 비효율적이므로, formatMessageQueueKey 유틸리티를 만들었습니다. 이 함수는 단순히 문자열들을 하나로 합쳐줍니다.
또한 데이터를 Redis에 저장하려면 직렬화(Serialize)가 필요합니다. JavaScript 객체를 그대로 전달할 수 없고 반드시 문자열로 변환해야 합니다. 데이터가 제네릭 타입이므로, 이를 처리하는 convertToJSONString 함수도 제네릭으로 구현했습니다.
이제 첫 번째 Lua 스크립트를 추가해 보겠습니다.
add-job.lua
--[[
key 1 -> [prefix]:name:jobs
key 2 -> [prefix]:name:waiting
arg 1 -> job id
arg 2 -> job data
]]


local jobId = ARGV[1]
local payload = ARGV[2]

if redis.call("hexists", KEYS[1], jobId) == 1 then return nil end
redis.call("hset", KEYS[1], jobId, payload)
redis.call("lpush", KEYS[2], jobId)

return jobId
사실 이 로직은 Lua 스크립트 없이 Redis 명령어를 개별적으로 호출해서도 구현할 수 있습니다.
redis.hexists(jobId)redis.hset(jobId,payload)redis.lpush(jobId,payload)
하지만 이렇게 하면 호출이 세 번 발생합니다. Redis 서버와의 왕복(Round Trip) 횟수를 최소화하기 위해 전체 과정을 하나의 호출로 묶는 것이죠. Lua 스크립트가 바로 이 역할을 수행합니다.
save() 메서드 추가하기
 private createQueueKey(key: string) {
 return formatMessageQueueKey(this.config.queueName, key);
 }

 async save(): Promise<string | null> {
 const addJobToQueueScript = await Bun.file("./src/lua-scripts/add-job.lua").text();
 const resJobId = (await this.config.redis.eval(
 addJobToQueueScript,
 2,
 this.createQueueKey("jobs"),
 this.createQueueKey("waiting"),
 this.id,
 convertToJSONString(this.data, this.status)
 )) as string | null;

 if (resJobId) {
 this.id = resJobId;
 return resJobId;
 }
 return null;
 }
코드 자체는 단순하지만 조금 더 설명하겠습니다. Lua 스크립트 파일을 읽어온 후 redis.eval로 실행합니다. Lua 스크립트 실행 시 파라미터 구성은 다음과 같습니다.
- 첫 번째 파라미터: 실행할 스크립트
- 두 번째 파라미터: KEY의 개수
- 세 번째·네 번째 파라미터: Redis 키(KEYS)
- 마지막: 실제 인자(ARGV)
Job 클래스를 마무리하기 전에, 앞으로 사용할 두 가지 메서드를 미리 추가하겠습니다.
fromId = async <T>(jobId: string): Promise<Job<T> | null> => {
 const jobData = await this.config.redis.hget(this.createQueueKey("jobs"), jobId);
 if (jobData) {
 return this.fromData<T>(jobId, jobData);
 }
 return null;
 };

private fromData = <T>(jobId: string, stringifiedJobData: string): Job<T> => {
 const parsedData = JSON.parse(stringifiedJobData) as Job<T>;
 const job = new Job<T>(this.config, parsedData.data, jobId);
 job.status = parsedData.status;
 return job;
};
지금 당장은 필요 없어 보이지만, 나중에 작업을 실제로 처리할 때 매우 중요해집니다. 그때는 작업의 ID(jobId)만 가지고 있게 되는데, 이 ID로 Job 객체를 다시 복원하는 메서드가 필요합니다. 바로 fromId가 하는 일입니다. Redis에서 작업 데이터를 조회하고, 이를 Job 인스턴스로 변환해 반환함으로써 큐가 이후 해당 작업을 처리할 수 있게 해줍니다.
Queue 클래스 구현하기
save() 부분이 완성되었으니 이제 Queue 클래스의 세부 사항으로 넘어가겠습니다. 목표는 다음과 같습니다.
- 성공 또는 실패 시 데이터를 보존하거나 삭제할 수 있는 옵션 제공 — 나중에 재처리가 필요한 경우를 대비합니다.
- 여러 작업이 동시에 실행될 수 있도록 동시성(Concurrency) 지원.
- 데이터 처리용 콜백 함수를 전달할 수 있게 하고, Job의 타입을 자동 추론하도록 설계해 개발자 경험(DX)을 높입니다.
- 큐 내부에서
Job.save()를 호출할 수 있도록 Redis 인스턴스와queueName을 전달합니다. - 필요할 때 큐 전체를 삭제(Destroy)하거나 특정 작업을 큐에서 제거할 수 있게 합니다.
Queue 정의부터 시작
export type QueueConfig = {
 redis: Redis;
 queueName: string;
 keepOnSuccess?: boolean;
 keepOnFailure?: boolean;
};

export class Queue extends EventEmitter {
 config: QueueConfig;
 concurrency = 0;
 worker: any;
 running = 0;
 queued = 0;

 constructor(config: QueueConfig) {
 super();
 this.config = {
 redis: config.redis,
 queueName: config.queueName,
 keepOnFailure: config.keepOnFailure ?? true,
 keepOnSuccess: config.keepOnSuccess ?? true,
 };
 }

 createQueueKey(key: string) {
 return formatMessageQueueKey(this.config.queueName, key);
 }
}
Queue 클래스는 외부로부터 큐 이름, Redis 인스턴스, 데이터 보존/삭제 설정 등의 정보를 받는 config를 포함합니다.
Redis 구현체는 사용자가 선호하는 무엇이든 사용할 수 있도록 유연하게 설계했습니다. 물론 우리는 Upstash를 특별히 선호합니다 😌. 덕분에 사용자는 기존 시스템에 손쉽게 큐를 통합할 수 있습니다.
또한 클래스가 EventEmitter를 상속하므로, 큐에서 무슨 일이 벌어질 때마다 사용자에게 알림을 보낼 수 있습니다.
초기화 예시
const queue = new Queue({
 redis: new Redis(process.env.UPSTASH_REDIS_URL),
 queueName: "upstash-rocks",
 keepOnFailure: true,
 keepOnSuccess: true,
});
작업 추가 (Add)
async add<T>(payload: T) {
 return new Job<T>(this.config, payload).save();
}
add 메서드는 부모 큐의 설정 정보와 저장할 payload를 받아 새 Job을 생성하고 저장합니다.
이제 아래처럼 사용할 수 있습니다.
const queue = new Queue({
 redis: new Redis(process.env.UPSTASH_REDIS_URL!),
 queueName: "mytest-queue",
 keepOnFailure: true,
 keepOnSuccess: true,
});

const payload = {
 upstash: "best-redis-ever",
};

await queue.add(payload);
이제 작업을 처리하는 방법이 필요합니다.
작업 처리 (Processing)
이 부분이 큐 구현에서 가장 까다로운 부분입니다. 사용자가 동시에 실행할 프로세스 수(concurrency)를 지정하고, 작업을 처리할 워커(worker) — 즉 Job의 타입을 추론하는 콜백 함수 — 를 제공해야 합니다.
또한 현재 실행 중인 작업 수와 대기 중인 작업 수를 추적하는 메커니즘이 필요합니다. 이를 통해 큐에서 안전하게 다음 작업을 꺼낼 수 있습니다.
 async process<TJobPayload>(
 worker: (job: TJobPayload) => void,
 concurrency: number
 ): Promise<void> {
 this.concurrency = concurrency;
 this.worker = worker;
 this.running = 0;
 this.queued = 1;

 this.jobTick();
 }
제네릭 TJobPayload를 받는 주된 이유는 사용자의 개발자 경험을 높이기 위해서입니다. 사용자가 우리 큐를 사용할 때 인텔리센스(Intellisense)의 도움을 받을 수 있도록 하는 것이죠.
사용자는 Job에 {hello: "world"} 같은 데이터를 저장했다는 것을 알지만, TypeScript는 정확한 인텔리센스를 제공하기 위해 약간의 도움이 필요합니다. 바로 이런 메커니즘이 TypeScript에게 타입을 알려주고 추론하도록 강제하는 역할을 합니다.
jobTick()으로 넘어가기 전에 전체 흐름을 정리해 보겠습니다.
- 큐는 FIFO(선입선출) 방식으로 동작하므로, 큐의 오른쪽 끝에서 작업을 꺼내는 것부터 시작합니다.
- 꺼낸 작업에 대해 워커 함수를 실행합니다.
- 작업이 완료되면 결과를 사용자에게 emit(발행)합니다.
- 마지막으로
jobTick()을 다시 호출해 다음 작업을 처리합니다.
따라서 jobTick()은 이 세 가지 핵심 부분으로 구성됩니다.
private jobTick() {
 this.getNextJob()
 .then(async (jobId) => {
 this.running += 1;
 this.queued -= 1;
 if (this.running + this.queued < this.concurrency) {
 this.queued += 1;
 setImmediate(this.jobTick);
 }

 if (!jobId) {
 return;
 }

 const jobCreatedById = await new Job(this.config, null).fromId(jobId);
 if (jobCreatedById) {
 await this.executeJob(jobCreatedById);
 } else {
 console.error(`Job not found with ID: ${jobId}`);
 }
 })
 .catch((error) => {
 console.error("Error in jobTick:", error);
 })
 .finally(() => {
 setImmediate(() => this.jobTick());
 });
 }
함수별로 하나씩 설명해 보겠습니다. 먼저 getNextJob()부터 시작합니다.
 private async getNextJob() {
 try {
 const jobId = await this.config.redis.brpoplpush(
 this.createQueueKey("waiting"),
 this.createQueueKey("active"),
 0
 );
 return jobId;
 } catch (error) {
 console.error("Error fetching the next job:", error);
 throw error;
 }
 }
단순히 Redis를 호출하는 것 같지만, 전략적인 접근이 담겨 있습니다. brpoplpush는 블로킹(Blocking) 호출과 lpush를 결합한 명령으로, 왕복 횟수를 최소화합니다.
블로킹 호출을 사용한 것은 의도적인 선택입니다. 다른 워커들이 동일한 작업을 동시에 처리하는 상황, 즉 경쟁 상태(Race Condition)를 방지하기 위해서입니다. 또한 작업을 'waiting' 상태에서 'active' 상태로 이동시켜 다음 단계를 준비합니다.
this.getNextJob().then(async (jobId) => {
 this.running += 1;
 this.queued -= 1;
 if (this.running + this.queued < this.concurrency) {
 this.queued += 1;
 setImmediate(this.jobTick);
 }

 if (!jobId) {
 return;
 }

 const jobCreatedById = await new Job(this.config, null).fromId(jobId);
 if (jobCreatedById) {
 await this.executeJob(jobCreatedById);
 } else {
 console.error(`Job not found with ID: ${jobId}`);
 }
});jobId를 확보하면 실행 중인 작업 수는 1 증가시키고 대기 수는 1 감소시킵니다.
그리고 동시성 제한을 준수하면서 가능한 한 많은 새 작업을 시작하려고 시도합니다.
if (this.running + this.queued < this.concurrency) {
 this.queued += 1;
 setImmediate(this.jobTick);
}
문제가 없다면 fromId를 사용해 Job 객체를 복원합니다. ID로 작업을 성공적으로 복구하면, 워커 함수로 해당 작업을 실행합니다.
이제 executeJob으로 넘어가겠습니다.
private async executeJob<TJobPayload>(jobCreatedById: Job<TJobPayload>) {
 let hasError = false;
 try {
 await this.worker(jobCreatedById.data);
 this.running -= 1;
 this.queued += 1;
 } catch (error) {
 hasError = true;
 } finally {
 const [jobStatus, job] = await this.finishJob<TJobPayload>(jobCreatedById, hasError);
 this.emit(jobStatus, job.id);
 return;
 }
 }
Job의 데이터를 확보했으므로 이 데이터를 worker에 전달합니다. 성공적으로 실행되면 대기 작업 수를 1 증가시키고 실행 중인 수를 1 감소시킵니다. 이 단계는 매우 중요합니다. 올바르게 처리하지 않으면 새로운 작업을 동시에 실행하는 능력에 영향을 줄 수 있습니다. 워커 실행 중 에러가 발생하면 단순히 hasError 플래그를 true로 변경합니다.
마지막으로 finishJob을 jobCreatedById와 hasError 플래그와 함께 호출하고, 작업 상태를 jobId와 함께 emit합니다.
참고로, 사용자는 이렇게 emit되는 업데이트를 리스닝(listening)할 수 있습니다.
queue.on("succeeded", (jobId) => console.log("Succeeded jobId", jobId));이제 finishJob을 살펴보겠습니다.
private async finishJob<TJobPayload>(
 job: Job<TJobPayload>,
 hasFailed?: boolean
 ): Promise<[JobStatuses, Job<TJobPayload>]> {
 const multi = this.config.redis.multi();

 multi.lrem(this.createQueueKey("active"), 0, job.id);

 if (hasFailed) {
 if (this.config.keepOnFailure) {
 multi.hset(this.createQueueKey("jobs"), job.id, convertToJSONString(job.data, job.status));
 multi.sadd(this.createQueueKey("failed"), job.id);
 } else {
 multi.hdel(this.createQueueKey("jobs"), job.id);
 }
 job.status = "failed";
 } else {
 if (this.config.keepOnSuccess) {
 multi.hset(this.createQueueKey("jobs"), job.id, convertToJSONString(job.data, job.status));
 multi.sadd(this.createQueueKey("succeeded"), job.id);
 } else {
 multi.hdel(this.createQueueKey("jobs"), job.id);
 }
 job.status = "succeeded";
 }

 await multi.exec();
 return [job.status, job];
 }
여기서 중요한 점은 multi()의 사용입니다. 역시 왕복 횟수를 항상 최소화하는 것이 목표이기 때문입니다. multi를 사용하면 Redis가 exec()을 호출할 때까지 실행을 지연시킵니다.
사용자가 keepOnFailure와 keepOnSuccess를 설정해 데이터를 보존하기로 했다면, 두 개의 집합(Set)을 만듭니다. 하나는 작업의 데이터를 담고, 다른 하나는 해당 데이터에 접근할 수 있도록 작업 ID 목록을 담습니다. 이 방식은 성공과 실패 양쪽 모두에 적용됩니다. 당연히 작업의 상태도 그에 맞게 갱신합니다. 마지막으로 exec으로 multi 명령을 실행하고, 이벤트 발행을 위해 작업 상태와 작업 객체 자체를 반환합니다.
마지막으로 두 개의 메서드가 남았습니다. 이미 익숙한 개념들을 활용하므로 자세히 설명하지는 않겠습니다.
 async removeJob(jobId: string) {
 const addJobToQueueScript = await Bun.file("./src/lua-scripts/remove-job.lua").text();
 return await this.config.redis.eval(
 addJobToQueueScript,
 5,
 this.createQueueKey("succeeded"),
 this.createQueueKey("failed"),
 this.createQueueKey("waiting"),
 this.createQueueKey("active"),
 this.createQueueKey("jobs"),
 jobId
 );
 }

 async destroy() {
 const args = ["id", "jobs", "waiting", "active", "succeeded", "failed"].map((key) =>
 this.createQueueKey(key)
 );
 const res = await this.config.redis.del(...args);
 return res;
 }
remove-job.lua
--[[
key 1 -> [prefix]:test:succeeded
key 2 -> [prefix]:test:failed
key 3 -> [prefix]:test:waiting
key 4 -> [prefix]:test:active
key 5 -> [prefix]:test:jobs
arg 1 -> jobId
]]

local jobId = ARGV[1]

if (redis.call("sismember", KEYS[1], jobId) + redis.call("sismember", KEYS[2], jobId)) == 0 then
 redis.call("lrem", KEYS[3], 0, jobId)
 redis.call("lrem", KEYS[4], 0, jobId)
end

redis.call("srem", KEYS[1], jobId)
redis.call("srem", KEYS[2], jobId)
redis.call("hdel", KEYS[5], jobId)
destroy()는 큐 전체를 완전히 삭제하는 메서드이고, removeJob()은 큐에서 특정 작업 하나를 제거하는 메서드입니다.
전체 동작 확인하기
import { sleep } from "bun";
import Redis from "ioredis";

import { Queue } from "./queue";

type Payload = {
 id: number;
 data: string;
};

const queue = new Queue({
 redis: new Redis(process.env.UPSTASH_REDIS_URL),
 queueName: "mytest-queue",
});

async function main() {
 await generateQueueItems(queue, 20);
 console.log("Sleep starting for 5 sec");
 await sleep(5000);

 queue.on("succeeded", (jobId) => console.log("Succeeded jobId", jobId));
 await queue.process<Payload>((job) => {
 console.log("Processing job:", job.data);
 sleep(1000);
 }, 3);
}

main();

async function generateQueueItems(queue: Queue, itemCount: number) {
 for (let i = 0; i < itemCount; i++) {
 const payload = {
 id: i,
 data: `dummy-data-${i}`,
 // 테스트에 필요한 속성을 추가하세요
 };
 const jobId = await queue.add(payload);
 console.log(`Added item ${i} with jobId: ${jobId}`);
 }
}
도전 과제 (Bonus Challenges)
- Redis 접근 및 워커 프로세스 양쪽에 지수 백오프(Exponential Backoff) 기반의 재시도 로직 구현하기
- '최소 한 번(At Least Once)' 전달 보장 메커니즘 개발하기
- 더 나은 성능을 위해 Service Worker에서 워커 실행해 보기
- 예약 작업(Scheduled Jobs) 기능 추가하기
마무리
무언가를 배우는 가장 좋은 방법은 직접 만들어 보는 것이고, 더욱 좋은 방법은 Upstash Redis로 만들어 보는 것입니다. 즐거운 코딩 되세요!
🔗 프로젝트 GitHub 주소